Une plateforme de veille et de reporting automatisée, conçue pour transformer des sources hétérogènes en information exploitable, traçable et publiable.
La plateforme
Industry Intelligence Platform est une application locale autonome qui produit des rapports périodiques enrichis par IA sur l’industrie de la localisation et les tendances technologiques. Ce projet personnel illustre une pratique récente de conception fonctionnelle, RUN/BUILD et développement assisté par IA ; il ne constitue pas une livraison client.
Public visé
Pour les professionnels de la localisation, des technologies linguistiques et du produit
Cette étude s’adresse aux personnes qui souhaitent comprendre comment concevoir, tester et rendre vérifiable un workflow de veille utile.
La plateforme reste un produit indépendant en évolution. Les suggestions et retours constructifs sont les bienvenus.
Le besoin produit et les objectifs d’apprentissage
La plateforme répond à un besoin concret : suivre le secteur de la localisation et les technologies émergentes sans lire manuellement des dizaines de sources. Elle constitue un premier filtre, tandis que les articles originaux restent la référence pour la lecture et le jugement humains.
Elle sert aussi de démonstrateur de conception fonctionnelle et de product building : la démarche de développement fait partie de la proposition de valeur et rend visible le processus de bout en bout, au même titre que la fonctionnalité finale.
Objectifs de la démarche de développement
Explorer le processus complet de conception et de développement dans une perspective d’auto-apprentissage et de Vibe Coding
Tester, régler et qualifier de petits modèles IA locaux pour un cas d’usage précis
Approfondir les enjeux liés aux API, aux intégrations et à l’automatisation
Garder le MVP ouvert à de futures fonctions comme l’analyse de sentiment et les embeddings
La plateforme reste un produit indépendant en évolution. Les suggestions et retours constructifs sont les bienvenus.
Les signaux sectoriels existent, mais ils sont dispersés, d’importance variable et peuvent facilement perdre leur provenance. La plateforme organise la collecte, la qualification et la restitution afin d’accélérer la lecture sans perdre le contexte.
Cadrage produit
Définir besoins, utilisateurs, priorités et critères pratiques d’utilité.
Conception de solution
Architecture modulaire, contrats de données et expérience éditoriale de lecture.
Automatisation raisonnée
Utiliser l’IA lorsqu’elle accélère le travail, avec validation et traçabilité.
Qualité et enablement
Tests, garde-fous et documentation pour conserver un système maintenable.
La plateforme reste un produit indépendant en évolution. Les suggestions et retours constructifs sont les bienvenus.
Un prompt affiné, accompagné de fichiers contenant une liste de sources curatées. Très rapide à essayer, mais chaque exécution reste largement manuelle et dépend de la qualité du prompt et du contexte fourni.
Mise en place faible · répétabilité manuelle
Formules gratuites ou abonnement ; limites d’usage et dépendance au modèle possibles
Workflow personnalisé n8n + RSS + LLM
Une chaîne d’automatisation configurable combinant flux, transformations et LLM local ou cloud. Grande souplesse, mais besoin d’intégration et de maintenance continue.
Moyenne à forte · développement et supervision
Cœur open source possible ; hébergement, maintenance et usage d’un modèle cloud peuvent être récurrents
Feedly AI
Un lecteur commercial soigné pour la veille, avec découverte de sources, filtrage et priorisation assistée par IA. Adoption simple, mais contrôle limité sur le workflow interne.
Faible à moyenne · paramétrage guidé
Abonnement payant ; disponibilité gratuite et profondeur fonctionnelle selon la formule
Inoreader Intelligence
Un environnement puissant de flux et de monitoring avec règles, filtres et traitement assisté par IA. Plus configurable qu’un lecteur simple, mais dépendant d’un service hébergé.
Moyenne · règles et sources à configurer
Freemium ou abonnement payant selon les limites et fonctionnalités avancées
AlphaSense
Une plateforme d’intelligence et de recherche d’entreprise, conçue pour une large couverture de contenus propriétaires et des workflows professionnels de découverte.
Forte · adoption d’entreprise
Abonnement commercial entreprise ; coût et engagement généralement les plus élevés de ces options
Ce que ce projet cherche à optimiserLa voie la plus rapide est la requête ponctuelle à une IA. La voie opérationnelle la plus simple est le lecteur hébergé. Les workflows n8n offrent davantage de contrôle, mais ajoutent une charge d’exploitation. La plateforme présentée ici se situe entre ces approches : configuration et provenance restent inspectables, le traitement local est privilégié lorsque cela est réaliste, et le workflow répétable produit une restitution publiable sans dépendre entièrement d’un service d’IA public.
La plateforme reste un produit indépendant en évolution. Les suggestions et retours constructifs sont les bienvenus.
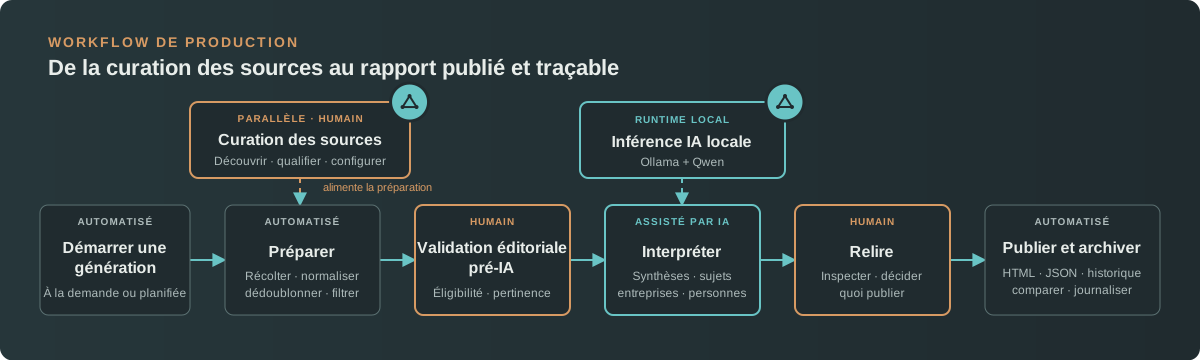
La gouvernance humaine guide chaque étape : les personnes définissent le périmètre, valident les contenus avant et après le traitement IA et restent responsables des décisions de publication.
Chaque exécution terminée laisse des sorties publiables et une trace interne. La validation éditoriale pré-IA pourra être davantage automatisée lors d’une prochaine version, après la période actuelle d’observation.
Boucle de curation asynchroneDécouverte des sources · contrôle des politiques · qualification des connecteurs · mises à jour de configuration
La plateforme reste un produit indépendant en évolution. Les suggestions et retours constructifs sont les bienvenus.
Le périmètre couvre presse et analystes spécialisés, associations et think tanks, grands LSP, TMS et plateformes de localisation, fournisseurs d’IA linguistique et acteurs émergents de l’orchestration multilingue.
Pertinence
Language AI, MT, LLM, qualité, automatisation, gouvernance, agents, TMS et workflows.
Activité récente
Les pages officielles et publications récentes sont vérifiées avant intégration.
Découverte respectueuse
Les politiques des sites et indications robots sont respectées, sans contourner les accès.
Jugement éditorial
Le résultat automatisé reste un filtre ; les sources originales permettent la vérification.
La plateforme reste un produit indépendant en évolution. Les suggestions et retours constructifs sont les bienvenus.
Local lorsque cela compte, assisté lorsque cela aide
Assistance au développement
Des modèles avancés de raisonnement via Codex ont aidé l’architecture initiale et les premières implémentations
Des modèles plus légers ont servi aux raffinements, tests récurrents et à la maintenance
Pour le traitement des rapports, aucune donnée traitée par le runtime IA local n’est transmise à des services d’IA tiers ni utilisée pour leur entraînement. Le traitement reste local et confidentiel. La qualification itérative du LLM et du runtime locaux a aussi permis de mieux comprendre les enjeux de prompt engineering et d’économie de tokens, afin de trouver le meilleur équilibre entre sobriété, fiabilité et qualité du résultat.
Principe de fonctionnementPrivilégier l’automatisation Python déterministe pour la rapidité, le coût, la prévisibilité et la traçabilité. Utiliser l’IA lorsque le problème à résoudre est l’interprétation.
La plateforme reste un produit indépendant en évolution. Les suggestions et retours constructifs sont les bienvenus.
La plateforme est conçue pour évoluer principalement par configuration. Les sources peuvent être ajoutées ou retirées via la curation assistée par IA, les thèmes suivis peuvent être modifiés, le workflow peut être adapté à une autre industrie et la fréquence de génération peut être ajustée sans revoir l’architecture fonctionnelle.
Échelle par configuration
Ajouter sources et critères, modifier les thèmes, adapter le périmètre ou introduire de nouvelles étapes de qualification sans réécrire le cœur. La validation pré-IA pourra évoluer ; une interface web rendra ensuite les paramètres essentiels, le contrôle des exécutions et la curation plus accessibles.
Échelle par efficacité d’exécution
Cache, dédoublonnage renforcé avec analyse de proximité assistée par IA, traitement par lots, parallélisation et réutilisation des résultats historiques limitent le travail répété.
Échelle par choix d’infrastructure
La limite principale est la capacité locale de traitement IA. Les options sont un matériel local plus puissant ou une architecture hybride, avec des arbitrages de coût, confidentialité, localisation des données et dépendance fournisseur.
Position de conceptionLa configuration est séparée du code afin que la croissance reste progressive, auditable et réversible. Les changements d’infrastructure ne doivent intervenir que lorsque l’efficacité d’exécution et la capacité locale ne permettent plus un équilibre raisonnable.
La plateforme reste un produit indépendant en évolution. Les suggestions et retours constructifs sont les bienvenus.
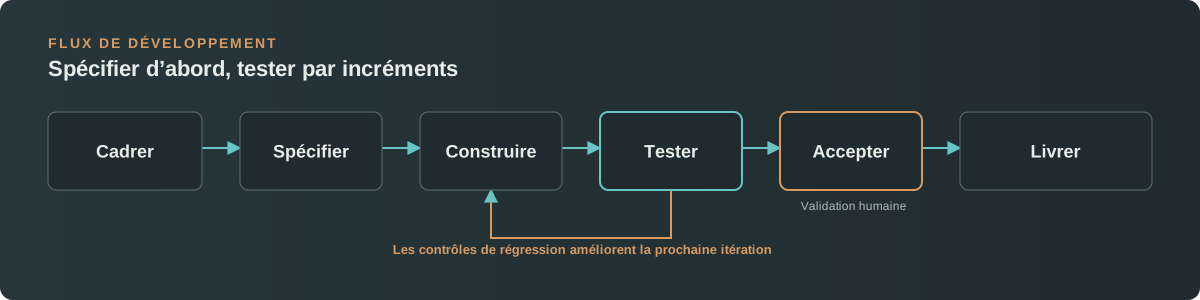
Avec ou sans assistance IA, le projet suit le schéma standard Git et GitHub pour le versionnement, la revue et la traçabilité des livraisons. Les spécifications fonctionnelles, d’architecture, de données et de version guident un développement par blocs. Les autotests et contrôles de régression précèdent l’inspection humaine et la validation formelle. Près de 300 autotests de non-régression soutiennent le processus actuel, y compris les tests de modules, les tests fonctionnels globaux et l’arbitrage humain.
La plateforme reste un produit indépendant en évolution. Les suggestions et retours constructifs sont les bienvenus.
Le travail le plus long a consisté à préparer exigences, garde-fous, architecture et contrats de données, puis à itérer sur sources, prompts, tests et qualité.
L’IA est une assistante, pas l’auteur. Elle peut échouer subtilement : la vérification humaine des sources, chiffres et hypothèses reste indispensable.
La qualité dépend d’abord de la définition produit, et non de la vitesse de codage.
Gérée dans Obsidian et rédigée en Markdown, la documentation apporte une traçabilité détaillée ; consigner les étapes assistées par IA facilite aussi le retour sur les décisions. Toutefois, même pour un projet individuel, le suivi exhaustif des itérations de développement de cette manière ne passe pas à l’échelle sur la durée. À mesure que le produit grandit, les outils professionnels de gestion du travail tels que Jira restent la norme privilégiée pour les epics, user stories et le suivi des versions, tandis qu’Obsidian demeure la mémoire durable des décisions et des spécifications.
!
Le développement assisté par IA peut accélérer le code et les tests, mais il condense aussi le travail humain nécessaire pour orienter, vérifier et décider. Des boucles de retour plus courtes demandent une attention soutenue, des validations plus rapides et des changements de contexte plus fréquents. Associés à la consommation continue d’informations générées par IA, ces facteurs peuvent provoquer une surcharge cognitive et une fatigue mentale. Les responsables produit doivent gérer ces pressions pour que les gains de productivité ne se fassent pas au détriment de pratiques durables.
La plateforme reste un produit indépendant en évolution. Les suggestions et retours constructifs sont les bienvenus.
Améliorer la curation et les connecteursAffiner prompts et arbitrage du modèle localExplorer sentiment, embeddings et vues comparativesÉtendre diffusion et intégrations webIntroduire une interface conviviale pour les paramètres essentiels de la plateforme et le contrôle des exécutions
Les embeddings pourraient à terme faciliter le dédoublonnage sémantique, la comparaison historique, le regroupement thématique et la détection de tendances. Ils ne font pas encore partie de l’implémentation actuelle, mais constituent une évolution naturelle vers un reporting plus riche et davantage contextualisé.
La plateforme reste un produit indépendant en évolution. Les suggestions constructives sont les bienvenues.